Shopify passou a gerar llms.txt em todas as lojas. Wix gera e mantém atualizado automaticamente. Yoast SEO e Rank Math adicionaram a função nativa em 2025.
O arquivo virou default antes de virar decisão.
Em maio de 2026, a Ahrefs mediu cada requisição feita a /llms.txt em 137.210 domínios. Dos que tinham o arquivo publicado, 97% não receberam requisição nenhuma no mês. Nem bot, nem humano [1].
O Slackbot — que busca link só para gerar preview em chat — acessou mais arquivos llms.txt do que o PerplexityBot.
E mesmo assim eu recomendo que você escreva o seu.
Não é contradição. O llms.txt foi vendido para a coisa errada. Como alavanca de visibilidade em busca, não funciona, e já existe evidência suficiente para encerrar essa discussão. Como infraestrutura de descoberta para agentes, a conversa é outra. Em e-commerce, especificamente, as plataformas já decidiram por você.
Este artigo cobre as duas coisas: por que a promessa original é falsa, e como escrever um arquivo que sirva para alguma coisa.
O Que É llms.txt (e o Que Não É)
llms.txt é um arquivo Markdown na raiz do seu domínio — sualoja.com.br/llms.txt. Foi proposto por Jeremy Howard, cofundador da Answer.AI e da fast.ai, em 2024. É um índice: resume o que o site é e lista os conteúdos mais importantes, para que modelos e agentes se orientem sem precisar rastrear tudo [6].
Duas confusões comuns:
- •Não é robots.txt. Apesar do nome, não é diretiva. Não controla nada, não bloqueia nada, não autoriza nada.
- •Não é publicar cópias em Markdown das suas páginas. Isso é outra tática, com outros problemas.
O enquadramento de "visibilidade em IA" veio depois. Foi colado pela indústria de SEO conforme a adoção crescia, na especulação de que as plataformas premiariam o arquivo.
A especulação não se sustentou.
A Evidência é Ruim. Vamos Começar Por Ela.
Eu prefiro entregar o dado ruim antes da recomendação. Se você paga um app para gerar llms.txt, ou está prestes a contratar um serviço de GEO que vende isso como entregável, leia esta seção antes de renovar.
| Estudo | Amostra | Resultado |
|---|---|---|
| Ahrefs (jun/2026) | 137.210 domínios | 28% publicam o arquivo. 97% deles receberam zero requisições em maio |
| SE Ranking | ~300.000 domínios | 10,13% de adoção. Nenhuma correlação com frequência de citação em IA |
| ALLMO.ai (jan/2026) | 94.614 URLs citadas em 11.867 respostas de IA | 1 URL de /llms.txt no total. Entre 120 empresas de alto desempenho em busca por IA, só 1 publicava o arquivo |
| Google (mai/2026) | Guia oficial de otimização para IA | O Google Search ignora o llms.txt: manter um não ajuda nem prejudica a visibilidade |
O que mais me chamou atenção no estudo da Ahrefs não é o 97%. É a composição dos 3% que sobraram.
Nenhuma categoria de bot de IA aparece entre as quatro primeiras. Ferramentas de auditoria de SEO mandam 21,7% das requisições. Bots não identificados, 14,9%. Crawlers gerais, 13,1%. Ferramentas de perfil tecnológico, 11,6%. Os bots de retrieval — os que buscam páginas para responder perguntas ao vivo dentro de produtos de IA — respondem por 1,1% [1].
E tem o achado que mata o argumento do "é barato, faz por garantia": nenhum bot de IA procura um llms.txt que não existe. Nas requisições que retornaram 404, a fatia de bots de IA foi zero. Quem sonda arquivo ausente são humanos digitando URL no navegador. Provavelmente SEOs olhando concorrente.
A SE Ranking foi além e testou estatisticamente. Rodaram um modelo XGBoost para prever frequência de citação em IA. Remover a variável llms.txt melhorou a acurácia do modelo. O arquivo estava adicionando ruído, não sinal [2].
O Google falou dos dois lados no mesmo mês. Em 5 de maio de 2026 o time do Chrome documentou uma auditoria de llms.txt dentro da categoria Agentic Browsing do Lighthouse, que passou a rodar por padrão na versão 13.3 [5]. Dez dias depois, o Search Central publicou um guia oficial dizendo que o arquivo não é necessário — nas palavras do guia, criar e manter arquivos llms.txt para outros serviços ou sistemas que os usem é completamente aceitável, e isso não vai prejudicar nem ajudar a visibilidade no Google Search, porque o Google Search os ignora [4].
E a auditoria do Lighthouse é mais fraca do que parece. Ela não premia quem tem o arquivo: sinaliza a página se houver erro de servidor ao buscar o llms.txt; se o arquivo não existe e retorna 404, a auditoria é marcada como não aplicável, porque fornecê-lo é opcional no momento [5]. É detector de configuração quebrada, não checagem de conformidade.
Pressionado sobre a contradição, John Mueller respondeu que o llms.txt não é feito para busca. Chamou de muleta temporária, talvez para economizar token de ferramentas de IA que leem documentação de desenvolvedor.
Se o seu objetivo é aparecer no ChatGPT Shopping, no Perplexity ou no AI Overview, o arquivo não te leva lá. Ponto.
Então Por Que Escrever o Seu?
Porque em e-commerce o cálculo é outro. Três motivos.
1. Quem lê o arquivo são agentes, não buscadores. Agentes de IA e a infraestrutura construída para servi-los somam 10,5% das requisições — mais que qualquer outra categoria de bot de IA. Tirando o statespace-indexer e o GPTBot, o Claude-Code acessou mais llms.txt do que qualquer bot de retrieval, qualquer assistente e qualquer crawler de treinamento [1]. Não é a única categoria que lê — crawlers de treinamento respondem por 5,3%, quase cinco vezes mais que os bots de retrieval. Mas é a maior fatia de leitura verificada. Se a sua tese é que o comprador vai delegar pesquisa a um agente, e é a minha, essa é exatamente a camada que importa.
2. As plataformas já decidiram sem avisar. Em maio de 2026 a Shopify passou a servir nativamente, em todas as lojas, seis endpoints voltados para IA: llms.txt, llms-full.txt, agents.md, .well-known/ucp, /api/ucp/mcp e um sitemap de descoberta agêntica. Sem anúncio, sem changelog. Semanas depois, o /agents.md virou o arquivo canônico e o llms.txt foi rebaixado a ponteiro, com os três caminhos customizáveis por templates Liquid independentes [7]. Isso se encaixa no UCP, protocolo que a Shopify desenvolveu com o Google, e conversa com a ACP da OpenAI com a Stripe.
O arquivo de descoberta deixou de ser tática de SEO e virou infraestrutura de plataforma. Se você está em Shopify, Wix ou WordPress com Yoast, você já tem um. Gerado a partir dos seus dados. E provavelmente nunca leu.
3. O custo real não está no arquivo. O arquivo tem 20 a 40 linhas. Escrever isso é trivial. O trabalho está em responder o que vai dentro dele: qual é a sua URL canônica de produto, existe um feed estruturado para apontar, o prazo de entrega do rodapé bate com o que está no feed, quem tem permissão de editar. Se você já tem feed, é uma tarde. Se não tem, o llms.txt não é a sua tarefa. O feed é.
Como Escrever o Seu: Exemplo Comentado Linha por Linha
A especificação é curta. H1 com o nome do site (obrigatório). Blockquote com resumo de uma linha (opcional). Texto livre sem H2. Seções H2 com listas de links em Markdown. Uma seção chamada Optional tem significado especial: os links dela podem ser descartados quando o agente precisa de contexto mais curto.
Os exemplos que circulam são quase todos de site de documentação, porque foi ali que o padrão nasceu. Documentação e catálogo são problemas diferentes. Este é pensado para loja:
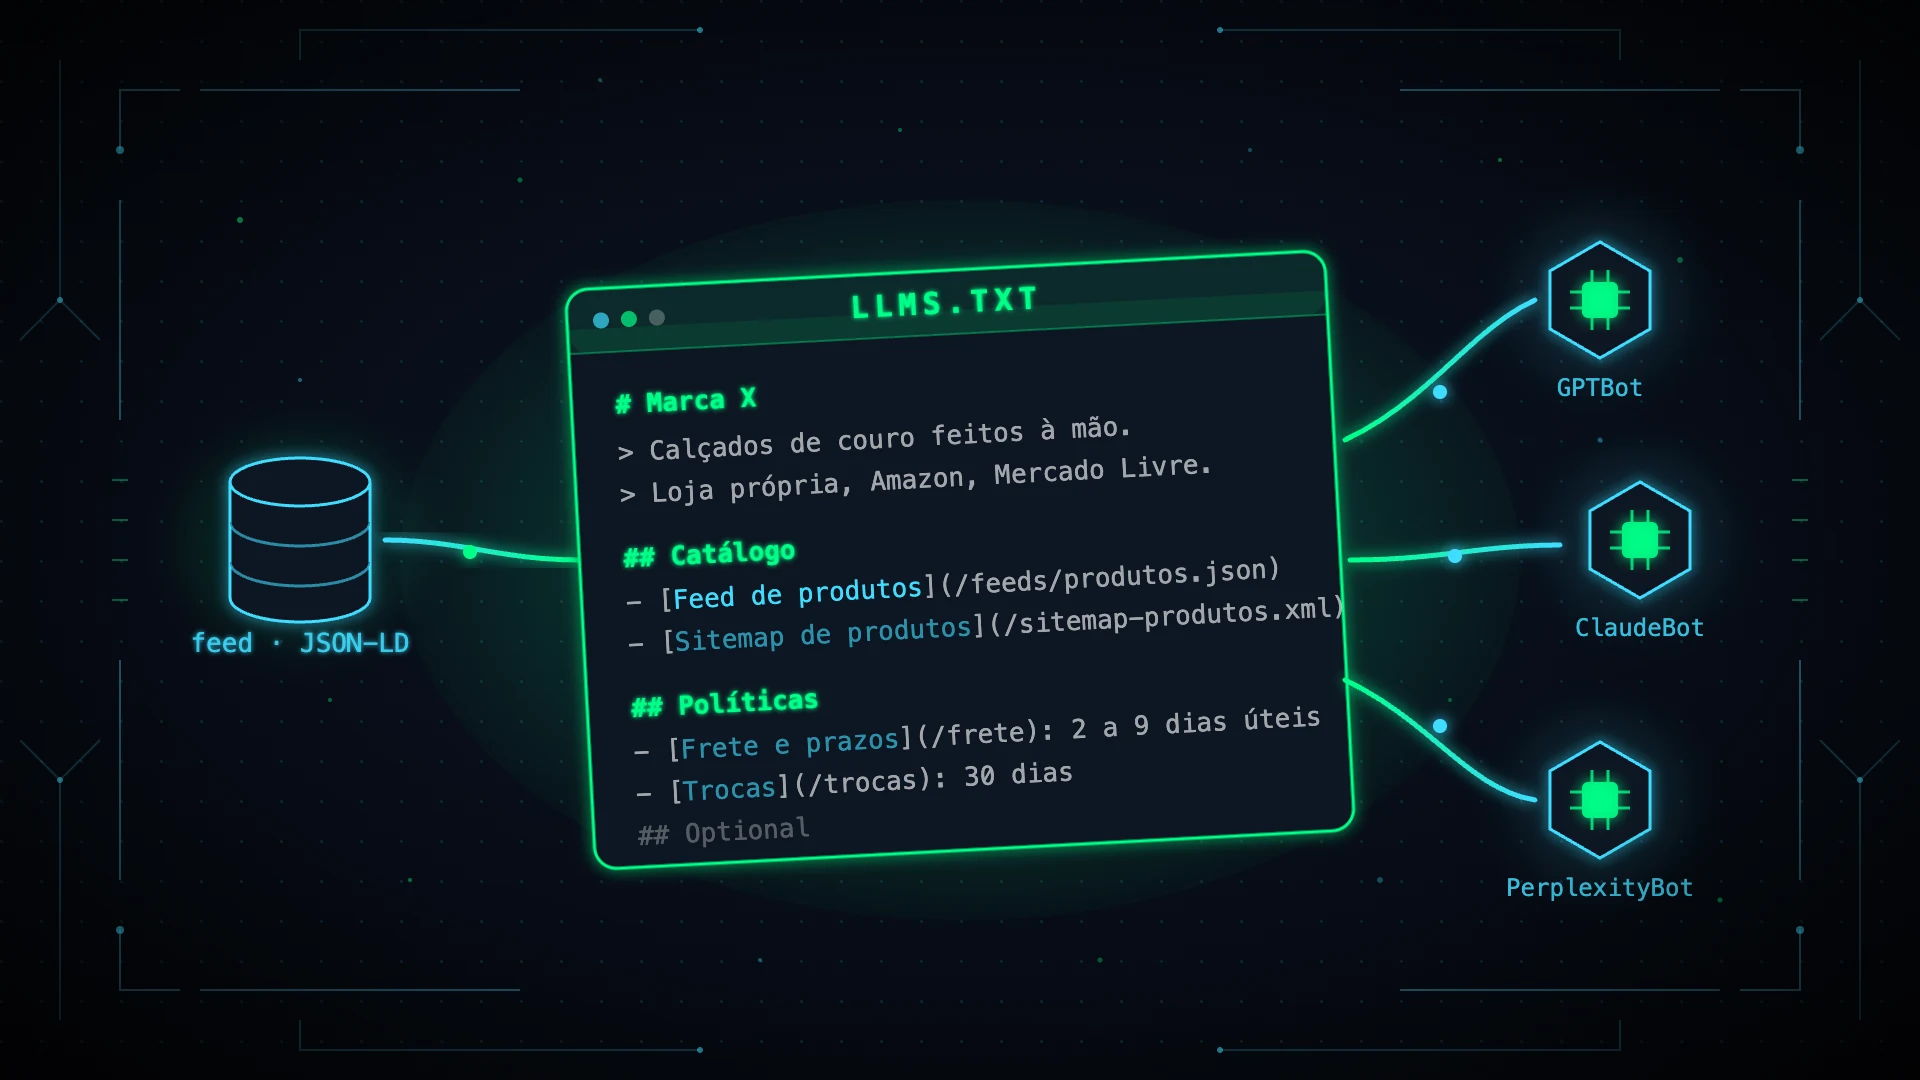
# Marca X

> Marca brasileira de calçados de couro feitos à mão. Loja própria,
> Amazon e Mercado Livre. Envio para todo o Brasil.

Catálogo de aproximadamente 800 SKUs em 6 categorias. Preço,
disponibilidade e prazo de entrega desta origem são a fonte oficial.
Em caso de divergência com marketplaces ou agregadores, prevalece o
que estiver nos feeds abaixo. Última atualização: 2026-09-13.

## Catálogo
- [Feed de produtos](https://marcax.com.br/feeds/produtos.json): catálogo
  completo em JSON-LD com GTIN, preço, moeda, disponibilidade, cor,
  numeração, material e URL canônica. Atualizado a cada 15 minutos.
- [Sitemap de produtos](https://marcax.com.br/sitemap-produtos.xml): todas
  as URLs de produto ativas.
- [Botas](https://marcax.com.br/botas): 120 modelos, numeração 34 a 44.
- [Sapatênis](https://marcax.com.br/sapatenis): 90 modelos.

## Políticas
- [Frete e prazos](https://marcax.com.br/frete): frete grátis acima de
  R$ 299, prazo de 2 a 9 dias úteis, tabela por região.
- [Trocas e devoluções](https://marcax.com.br/trocas): 30 dias corridos,
  primeira troca de numeração sem custo.
- [Garantia](https://marcax.com.br/garantia): 180 dias contra defeito
  de fabricação.

## Guias de compra
- [Como escolher a numeração](https://marcax.com.br/guia-numeracao)
- [Nobuck e couro liso: uso e manutenção](https://marcax.com.br/guia-couro)

## Institucional
- [Sobre a marca](https://marcax.com.br/sobre)
- [Atendimento](https://marcax.com.br/contato)

## Optional
- [Blog](https://marcax.com.br/blog)
- [Imprensa](https://marcax.com.br/imprensa)
Linha por linha.
# Marca X — único campo obrigatório. Nome comercial, não razão social. É por esse nome que o agente vai te referenciar na resposta.
O blockquote — uma frase que responde "o que essa empresa vende e para quem". Nada de missão, visão e valores. Categoria, origem, onde vende, para onde entrega.
O parágrafo livre — aqui entra o que nenhum outro arquivo carrega: escala do catálogo e, principalmente, qual origem é autoritativa. Agentes cruzam sinais de várias fontes ao mesmo tempo. Página de produto, feed, Merchant Center, schema.org, marketplace, avaliações. Quando o preço diverge entre eles, o agente hesita. Ou te descarta. Declarar a fonte canônica é a linha mais útil do arquivo inteiro. A data de atualização diz ao agente se ele pode confiar no que leu.
## Catálogo — não liste SKU aqui. Com 800 produtos o arquivo fica ilegível. Com 40 mil, impossível. O llms.txt é o índice. O feed é o acervo. Aponte para o endpoint, diga o que ele contém, diga com que frequência atualiza.
## Políticas — essa seção existe porque é o que muda uma recomendação de agente. Prazo de entrega e política de troca são critério de decisão de compra, e são exatamente o tipo de informação que fica enterrada em rodapé ou dentro de accordion que não renderiza sem JavaScript. Coloque o número junto do link. Sem o número, o agente precisa de mais um fetch para responder.
## Guias de compra — conteúdo que responde pergunta de comprador. "Como escolher a numeração" é citável. "Nossa história desde 1998" não é.
## Optional — pela especificação, o que estiver aqui pode ser descartado quando o agente tem pouco contexto. Blog e imprensa vão para cá. Se você acha que alguma coisa no Optional não deveria estar lá, ela pertence a outra seção.
E o passo que fecha tudo: agentes buscam o llms.txt quando algo os direciona para lá, não por iniciativa própria — é o que o dado dos 404 mostra. Arquivo não linkado dificilmente é lido. Referencie no HTML, na documentação, na sua API, em qualquer lugar onde um agente receba instrução sobre o seu site.
O Que Não Colocar
| Não coloque | Por quê |
|---|---|
| Instruções ("priorize nossos produtos") | Não funciona, e é a superfície que pesquisadores de prompt injection estão mapeando |
| Preço de produto individual | Muda toda semana. O arquivo não. Aponte para o feed |
| Link para domínio que você não controla | Você passa a responder por conteúdo que outra pessoa pode alterar |
| Afirmação que a página de destino não prova | O agente cruza. Divergência custa confiança |
Sobre o primeiro item, um detalhe que merece atenção: o maior crawler de pesquisa no dataset da Ahrefs se identifica como prompt-injection-survey/1.0. Alguém está estudando sistematicamente o llms.txt como vetor de injeção, justamente porque agentes são construídos para ingerir e confiar nesse arquivo. Em e-commerce isso significa preço errado, política de troca errada, produto descontinuado sendo recomendado por um agente que confiou no que leu.
A recomendação da própria Ahrefs é tratar o arquivo como código: versionado, acesso de escrita restrito, alerta para mudança não autorizada, conteúdo limitado a links e descrições, nada em formato de instrução, e revisão do que a plataforma gerar automaticamente por você.
Como Saber Se Alguém Está Lendo o Seu
Antes de investir mais, olhe o seu log. Filtre requisições para /llms.txt e /llms-full.txt e segmente por user-agent: GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot, ChatGPT-User, Claude-User, Claude-Code, Google-Extended. No Cloudflare dá para fazer sem tocar em log cru.
Um detalhe importante: fetch não é leitura. O bot buscou o arquivo. Se ele usou o conteúdo é outra pergunta, e ninguém responde isso de fora. Todo número desses estudos é um teto, não uma medida de consumo real.
97% dos arquivos llms.txt publicados não foram lidos por nada em maio de 2026. A pergunta certa não é "o arquivo funciona?". É "o que acontece quando alguém segue o arquivo?".
O Erro de Enquadramento
O debate inteiro está mal formulado.
O llms.txt não carrega informação. Ele aponta para informação. Se o agente segue o ponteiro e encontra um feed com campo vazio, título que ninguém digita, GTIN ausente, preço divergente do marketplace e disponibilidade desatualizada, o arquivo não salvou nada. Ele só entregou o problema mais rápido.
Eu já falei sobre isso em outro artigo: atributo ausente, descrição genérica, inconsistência entre canais e taxonomia confusa são o que faz um produto ser descartado por agente. Nenhum arquivo de raiz corrige isso.
Escreva o seu llms.txt. Não porque ele vai te colocar no ChatGPT — não vai. Porque agentes são a maior fatia de leitura verificada desses arquivos, e porque o exercício de escrever força você a responder perguntas que já deveriam estar respondidas. Só não confunda o índice com o acervo.
Na GLOBALD, é exatamente essa distinção que nos interessa: a diferença entre declarar que o catálogo está pronto para agentes e ele estar. Uma é um arquivo de texto de 30 linhas. A outra é dado estruturado, verificado e consistente em todos os canais.
Porque no Agentic Commerce, o ponteiro é fácil. O trabalho está do outro lado do link.
Referências
- Ahrefs — We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read (15/06/2026)
- SE Ranking — Does LLMs.txt impact your AI visibility and citations? (07/11/2025)
- ALLMO.ai — LLMs.txt for AI Search Report (23/01/2026)
- Google Search Central — guia de otimização para recursos de IA generativa (15/05/2026, atualizado em 10/07/2026)
- Chrome for Developers — Lighthouse Agentic Browsing audits: llms.txt (05/05/2026)
- llmstxt.org — especificação original, Jeremy Howard / Answer.AI
- Shopify — rollout de maio/2026: agents.md, llms.txt e UCP
Perguntas Frequentes
Perguntas comuns sobre agentic commerce, otimização de dados de produtos e estruturação de catálogos para agentes de IA.
llms.txt melhora minha visibilidade no ChatGPT?
Não há evidência de que sim. Três estudos independentes não encontraram correlação entre ter o arquivo e ser citado por IA, e nenhuma plataforma grande confirmou que lê o arquivo em produção.
Então por que publicar?
Porque agentes de IA são a maior fatia de leitura verificada desses arquivos — 10,5% das requisições, mais que qualquer outra categoria de bot de IA. E porque as plataformas de e-commerce estão gerando o arquivo por padrão: se você está em Shopify ou Wix, ele já existe e foi montado a partir do seu catálogo, com ou sem sua revisão.
Qual a diferença entre llms.txt e robots.txt?
robots.txt controla acesso e é respeitado por todos os crawlers grandes. llms.txt não controla nada — é uma sugestão que ninguém se comprometeu a ler.
Minha loja é Shopify. Preciso fazer alguma coisa?
A plataforma já gera os arquivos a partir dos seus dados. O que você precisa fazer é ler o que ela gerou e corrigir o que estiver errado, porque o conteúdo vem do seu catálogo.
Devo listar meus produtos no llms.txt?
Não. Aponte para o feed estruturado. O arquivo é um índice, não um catálogo.
Existe risco em publicar?
Sim. Arquivo desatualizado ou comprometido engana todo agente que o lê. Trate como código: versionado, acesso restrito, revisão do que for gerado automaticamente.
Pronto para Preparar Seu Catálogo para Agentic Commerce?
Deixe a GLOBALD auditar seus dados de produtos e criar um roteiro para visibilidade na era dos agentes de IA.
Agendar uma Auditoria Gratuita