Shopify empezó a generar llms.txt en todas las tiendas. Wix lo genera y lo mantiene actualizado automáticamente. Yoast SEO y Rank Math añadieron la función de forma nativa en 2025.
El archivo se volvió default antes de volverse una decisión.
En mayo de 2026, Ahrefs midió cada solicitud hecha a /llms.txt en 137.210 dominios. De los que tenían el archivo publicado, el 97% no recibió ninguna solicitud en el mes. Ni de bots ni de humanos [1].
Slackbot — que busca links solo para generar la vista previa en el chat — accedió a más archivos llms.txt que PerplexityBot.
Y aun así te recomiendo que escribas el tuyo.
No es una contradicción. El llms.txt se vendió para lo que no es. Como palanca de visibilidad en búsqueda, no funciona, y ya hay evidencia suficiente para cerrar esa discusión. Como infraestructura de descubrimiento para agentes, la conversación es otra. En e-commerce, específicamente, las plataformas ya decidieron por ti.
Este artículo cubre las dos cosas: por qué la promesa original es falsa y cómo escribir un archivo que sirva para algo.
Qué Es llms.txt (y Qué No Es)
llms.txt es un archivo Markdown en la raíz de tu dominio — tutienda.com/llms.txt. Lo propuso Jeremy Howard, cofundador de Answer.AI y de fast.ai, en 2024. Es un índice: resume qué es el sitio y enumera sus contenidos más importantes, para que modelos y agentes se orienten sin tener que rastrearlo todo [6].
Dos confusiones comunes:
- •No es robots.txt. A pesar del nombre, no es una directiva. No controla nada, no bloquea nada, no autoriza nada.
- •No es publicar copias en Markdown de tus páginas. Esa es otra táctica, con otros problemas.
El enfoque de "visibilidad en IA" llegó después. Lo agregó la industria del SEO a medida que crecía la adopción, con la especulación de que las plataformas premiarían el archivo.
La especulación no se sostuvo.
La Evidencia Es Mala. Empecemos por Ella.
Prefiero darte el dato malo antes que la recomendación. Si pagas una app para generar llms.txt, o estás a punto de contratar un servicio de GEO que lo vende como entregable, lee esta sección antes de renovar.
| Estudio | Muestra | Resultado |
|---|---|---|
| Ahrefs (jun/2026) | 137.210 dominios | El 28% publica el archivo. El 97% de ellos recibió cero solicitudes en mayo |
| SE Ranking | ~300.000 dominios | 10,13% de adopción. Ninguna correlación con la frecuencia de citación en IA |
| ALLMO.ai (ene/2026) | 94.614 URLs citadas en 11.867 respuestas de IA | 1 URL de /llms.txt en total. Entre 120 empresas de alto desempeño en búsqueda por IA, solo 1 publicaba el archivo |
| Google (may/2026) | Guía oficial de optimización para IA | Google Search ignora el llms.txt: tener uno no ayuda ni perjudica la visibilidad |
Lo que más me llamó la atención del estudio de Ahrefs no es el 97%. Es la composición del 3% restante.
Ninguna categoría de bot de IA aparece entre las cuatro primeras. Las herramientas de auditoría SEO envían el 21,7% de las solicitudes. Bots no identificados, 14,9%. Crawlers generales, 13,1%. Herramientas de perfil tecnológico, 11,6%. Los bots de retrieval — los que buscan páginas para responder preguntas en tiempo real dentro de productos de IA — representan el 1,1% [1].
Y está el hallazgo que liquida el argumento de "es barato, hazlo por si acaso": ningún bot de IA busca un llms.txt que no existe. En las solicitudes que devolvieron 404, la participación de bots de IA fue cero. Quienes sondean archivos inexistentes son humanos escribiendo la URL en el navegador. Probablemente SEOs mirando a la competencia.
SE Ranking fue más allá y lo probó estadísticamente. Corrieron un modelo XGBoost para predecir la frecuencia de citación en IA. Quitar la variable llms.txt mejoró la precisión del modelo. El archivo estaba agregando ruido, no señal [2].
Google se pronunció en los dos sentidos en el mismo mes. El 5 de mayo de 2026, el equipo de Chrome documentó una auditoría de llms.txt dentro de la categoría Agentic Browsing de Lighthouse, que pasó a ejecutarse por defecto en la versión 13.3 [5]. Diez días después, Search Central publicó una guía oficial que dice que el archivo no es necesario: según la guía, crear y mantener archivos llms.txt para otros servicios o sistemas que los usen es completamente aceptable, y eso no va a perjudicar ni a ayudar la visibilidad en Google Search, porque Google Search los ignora [4].
Y la auditoría de Lighthouse es más débil de lo que parece. No premia a quien tiene el archivo: marca la página si hay un error de servidor al buscar el llms.txt; si el archivo no existe y devuelve 404, la auditoría se marca como no aplicable, porque proporcionarlo es opcional por ahora [5]. Es un detector de configuración rota, no una verificación de cumplimiento.
Presionado sobre la contradicción, John Mueller respondió que el llms.txt no está hecho para la búsqueda. Lo llamó una muleta temporal, quizá para ahorrar tokens a herramientas de IA que leen documentación para desarrolladores.
Si tu objetivo es aparecer en ChatGPT Shopping, en Perplexity o en AI Overviews, el archivo no te lleva ahí. Punto.
¿Entonces Por Qué Escribir el Tuyo?
Porque en e-commerce la cuenta es otra. Tres motivos.
1. Quienes leen el archivo son agentes, no buscadores. Los agentes de IA y la infraestructura construida para servirlos suman el 10,5% de las solicitudes — más que cualquier otra categoría de bot de IA. Aparte de statespace-indexer y GPTBot, Claude-Code accedió a más archivos llms.txt que cualquier bot de retrieval, cualquier asistente y cualquier crawler de entrenamiento [1]. No es la única categoría que lee — los crawlers de entrenamiento representan el 5,3%, casi cinco veces más que los bots de retrieval. Pero es la mayor porción de lectura verificada. Si tu tesis es que el comprador va a delegar la investigación en un agente, y es la mía, esta es exactamente la capa que importa.
2. Las plataformas ya decidieron sin avisar. En mayo de 2026, Shopify empezó a servir de forma nativa, en todas las tiendas, seis endpoints orientados a IA: llms.txt, llms-full.txt, agents.md, .well-known/ucp, /api/ucp/mcp y un sitemap de descubrimiento agéntico. Sin anuncio, sin changelog. Semanas después, /agents.md pasó a ser el archivo canónico y llms.txt quedó relegado a puntero, con las tres rutas personalizables mediante templates Liquid independientes [7]. Esto encaja en UCP, el protocolo que Shopify desarrolló con Google, y dialoga con el ACP que OpenAI desarrolló con Stripe.
El archivo de descubrimiento dejó de ser una táctica de SEO y pasó a ser infraestructura de plataforma. Si estás en Shopify, Wix o WordPress con Yoast, ya tienes uno. Generado a partir de tus datos. Y probablemente nunca lo leíste.
3. El costo real no está en el archivo. El archivo tiene de 20 a 40 líneas. Escribirlo es trivial. El trabajo está en responder lo que va dentro: cuál es tu URL canónica de producto, si existe un feed estructurado al cual apuntar, si el plazo de entrega del pie de página coincide con lo que dice el feed, quién tiene permiso para editar. Si ya tienes feed, es una tarde. Si no lo tienes, el llms.txt no es tu tarea. El feed lo es.
Cómo Escribir el Tuyo: Ejemplo Comentado Línea por Línea
La especificación es corta. H1 con el nombre del sitio (obligatorio). Blockquote con un resumen de una línea (opcional). Texto libre sin H2. Secciones H2 con listas de links en Markdown. Una sección llamada Optional tiene un significado especial: sus links pueden descartarse cuando el agente necesita un contexto más corto.
Casi todos los ejemplos que circulan son de sitios de documentación, porque ahí nació el estándar. Documentación y catálogo son problemas distintos. Este está pensado para una tienda:
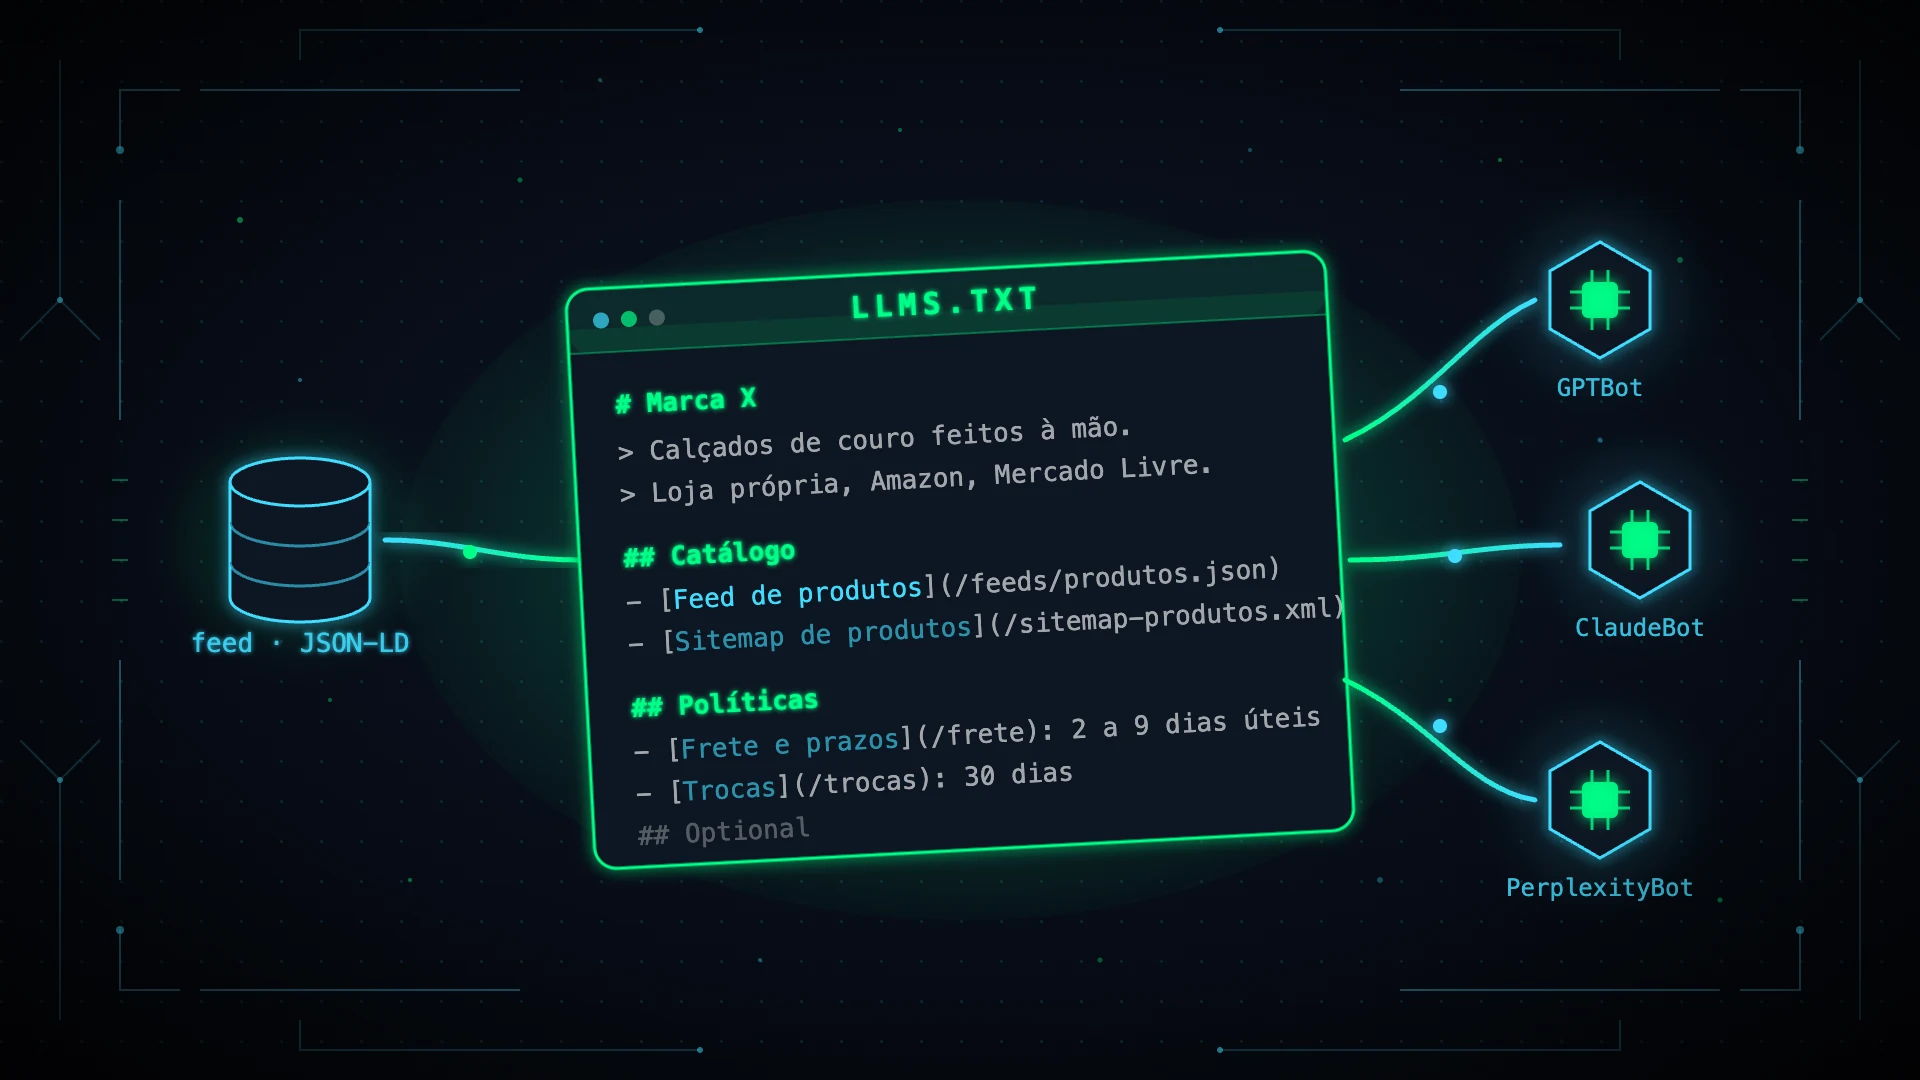
# Marca X

> Marca brasileña de calzado de cuero hecho a mano. Tienda propia,
> Amazon y Mercado Libre. Envíos a todo Brasil.

Catálogo de aproximadamente 800 SKUs en 6 categorías. Precio,
disponibilidad y plazo de entrega de este dominio son la fuente
oficial. En caso de divergencia con marketplaces o agregadores,
prevalece lo que esté en los feeds de abajo. Última actualización:
2026-09-13.

## Catálogo
- [Feed de productos](https://marcax.com.br/feeds/produtos.json):
  catálogo completo en JSON-LD con GTIN, precio, moneda,
  disponibilidad, color, talla, material y URL canónica. Actualizado
  cada 15 minutos.
- [Sitemap de productos](https://marcax.com.br/sitemap-produtos.xml):
  todas las URLs de producto activas.
- [Botas](https://marcax.com.br/botas): 120 modelos, tallas BR 34 a 44.
- [Sneakers](https://marcax.com.br/sapatenis): 90 modelos.

## Políticas
- [Envíos y plazos](https://marcax.com.br/frete): envío gratis en
  compras superiores a R$ 299, plazo de 2 a 9 días hábiles, tarifas
  por región.
- [Cambios y devoluciones](https://marcax.com.br/trocas): 30 días
  naturales, primer cambio de talla sin costo.
- [Garantía](https://marcax.com.br/garantia): 180 días contra defectos
  de fabricación.

## Guías de compra
- [Cómo elegir tu talla](https://marcax.com.br/guia-numeracao)
- [Nobuk y cuero liso: uso y mantenimiento](https://marcax.com.br/guia-couro)

## Institucional
- [Sobre la marca](https://marcax.com.br/sobre)
- [Atención al cliente](https://marcax.com.br/contato)

## Optional
- [Blog](https://marcax.com.br/blog)
- [Prensa](https://marcax.com.br/imprensa)
Línea por línea.
# Marca X — único campo obligatorio. Nombre comercial, no razón social. Es el nombre con el que el agente te va a mencionar en la respuesta.
El blockquote — una frase que responde "qué vende esta empresa y a quién". Nada de misión, visión y valores. Categoría, origen, dónde vende, a dónde envía.
El párrafo libre — aquí va lo que ningún otro archivo lleva: la escala del catálogo y, sobre todo, qué fuente es la oficial. Los agentes cruzan señales de varias fuentes al mismo tiempo. Página de producto, feed, Merchant Center, schema.org, marketplace, reseñas. Cuando el precio no coincide entre ellas, el agente duda. O te descarta. Declarar la fuente canónica es la línea más útil de todo el archivo. La fecha de actualización le dice al agente si puede confiar en lo que leyó.
## Catálogo — no listes SKUs aquí. Con 800 productos el archivo se vuelve ilegible. Con 40 mil, imposible. El llms.txt es el índice. El feed es el acervo. Apunta al endpoint, di qué contiene, di con qué frecuencia se actualiza.
## Políticas — esta sección existe porque es lo que cambia la recomendación de un agente. El plazo de entrega y la política de cambios son criterios de decisión de compra, y son exactamente el tipo de información que queda enterrada en el pie de página o dentro de un acordeón que no se renderiza sin JavaScript. Pon el número junto al link. Sin el número, el agente necesita un fetch más para responder.
## Guías de compra — contenido que responde preguntas de compradores. "Cómo elegir tu talla" es citable. "Nuestra historia desde 1998" no lo es.
## Optional — según la especificación, lo que esté aquí puede descartarse cuando el agente tiene poco contexto. El blog y la prensa van aquí. Si crees que algo en Optional no debería estar ahí, pertenece a otra sección.
Y el paso que cierra todo: los agentes buscan el llms.txt cuando algo los dirige hacia allí, no por iniciativa propia — es lo que muestra el dato de los 404. Un archivo que nadie enlaza rara vez se lee. Referéncialo en el HTML, en la documentación, en tu API, en cualquier lugar donde un agente reciba instrucciones sobre tu sitio.
Qué No Incluir
| No incluyas | Por qué |
|---|---|
| Instrucciones ("prioriza nuestros productos") | No funciona, y es justo la superficie que los investigadores de prompt injection están mapeando |
| Precios de productos individuales | Cambian todas las semanas. El archivo no. Apunta al feed |
| Links a dominios que no controlas | Pasas a responder por contenido que otra persona puede cambiar |
| Afirmaciones que la página de destino no respalda | El agente cruza datos. La divergencia cuesta confianza |
Sobre el primer punto, un detalle que merece atención: el mayor crawler de investigación en el dataset de Ahrefs se identifica como prompt-injection-survey/1.0. Alguien está estudiando sistemáticamente el llms.txt como vector de inyección, justamente porque los agentes están construidos para ingerir este archivo y confiar en él. En e-commerce eso significa precios equivocados, políticas de cambio equivocadas, productos descontinuados recomendados por un agente que confió en lo que leyó.
La recomendación de la propia Ahrefs es tratar el archivo como código: versionado, acceso de escritura restringido, alertas ante cambios no autorizados, contenido limitado a links y descripciones, nada en formato de instrucción, y revisión de lo que la plataforma genere automáticamente por ti.
Cómo Saber Si Alguien Está Leyendo el Tuyo
Antes de invertir más, mira tus logs. Filtra las solicitudes a /llms.txt y /llms-full.txt y segmenta por user-agent: GPTBot, ClaudeBot, PerplexityBot, OAI-SearchBot, ChatGPT-User, Claude-User, Claude-Code, Google-Extended. En Cloudflare se puede hacer sin tocar logs en crudo.
Un detalle importante: fetch no es lectura. El bot buscó el archivo. Si usó el contenido es otra pregunta, y nadie puede responderla desde afuera. Cada número de estos estudios es un techo, no una medida de consumo real.
El 97% de los archivos llms.txt publicados no fue leído por nada en mayo de 2026. La pregunta correcta no es "¿el archivo funciona?". Es "¿qué pasa cuando alguien sigue el archivo?".
El Error de Enfoque
Todo el debate está mal planteado.
El llms.txt no transporta información. Apunta a información. Si el agente sigue el puntero y encuentra un feed con campos vacíos, títulos que nadie escribe, GTIN ausente, precio distinto al del marketplace y disponibilidad desactualizada, el archivo no salvó nada. Solo entregó el problema más rápido.
Ya hablé de esto en otro artículo: atributos ausentes, descripciones genéricas, inconsistencias entre canales y taxonomías confusas son lo que hace que un agente descarte un producto. Ningún archivo en la raíz corrige eso.
Escribe tu llms.txt. No porque te vaya a poner en ChatGPT — no lo hará. Sino porque los agentes son la mayor porción de lectura verificada de estos archivos, y porque el ejercicio de escribirlo te obliga a responder preguntas que ya deberían estar respondidas. Solo no confundas el índice con el acervo.
En GLOBALD, es exactamente esa distinción la que nos interesa: la diferencia entre declarar que el catálogo está listo para agentes y que realmente lo esté. Una cosa es un archivo de texto de 30 líneas. La otra es dato estructurado, verificado y consistente en todos los canales.
Porque en el Agentic Commerce, el puntero es lo fácil. El trabajo está del otro lado del link.
Referencias
- Ahrefs — We Analyzed 137K Sites: 97% of llms.txt Files Never Get Read (15/06/2026)
- SE Ranking — Does LLMs.txt impact your AI visibility and citations? (07/11/2025)
- ALLMO.ai — LLMs.txt for AI Search Report (23/01/2026)
- Google Search Central — guía de optimización para funciones de IA generativa (15/05/2026, actualizada el 10/07/2026)
- Chrome for Developers — Lighthouse Agentic Browsing audits: llms.txt (05/05/2026)
- llmstxt.org — especificación original, Jeremy Howard / Answer.AI
- Shopify — lanzamiento de mayo de 2026: agents.md, llms.txt y UCP
Preguntas Frecuentes
Preguntas comunes sobre agentic commerce, optimización de datos de productos y estructuración de catálogos para agentes de IA.
¿llms.txt mejora mi visibilidad en ChatGPT?
No hay evidencia de que lo haga. Tres estudios independientes no encontraron correlación entre tener el archivo y ser citado por IA, y ninguna plataforma grande confirmó que lea el archivo en producción.
¿Entonces por qué publicarlo?
Porque los agentes de IA son la mayor porción de lectura verificada de estos archivos — el 10,5% de las solicitudes, más que cualquier otra categoría de bot de IA. Y porque las plataformas de e-commerce están generando el archivo por defecto: si estás en Shopify o Wix, ya existe y se construyó a partir de tu catálogo, con o sin tu revisión.
¿Cuál es la diferencia entre llms.txt y robots.txt?
robots.txt controla el acceso y lo respetan todos los crawlers grandes. llms.txt no controla nada — es una sugerencia que nadie se comprometió a leer.
Mi tienda está en Shopify. ¿Tengo que hacer algo?
La plataforma ya genera los archivos a partir de tus datos. Lo que tienes que hacer es leer lo que generó y corregir lo que esté mal, porque el contenido viene de tu catálogo.
¿Debo listar mis productos en el llms.txt?
No. Apunta al feed estructurado. El archivo es un índice, no un catálogo.
¿Hay riesgo en publicarlo?
Sí. Un archivo desactualizado o comprometido engaña a todo agente que lo lea. Trátalo como código: versionado, acceso restringido, revisión de lo que se genere automáticamente.
¿Listo para Preparar Tu Catálogo para Agentic Commerce?
Deja que GLOBALD audite tus datos de productos y cree un plan para la visibilidad en la era de los agentes de IA.
Programar una Auditoría Gratuita